Американская компания по инфраструктуре ИИ Tensormesh совместно с AMD расширяет память GPU, снижая задержку первого токена до 0,5 секунды
Репортаж от Wedoany,Американская компания по инфраструктуре ИИ Tensormesh и AMD (Advanced Micro Devices) объявили о сотрудничестве, в рамках которого внешняя память ускорителей рассматривается как расширение ёмкости GPU, чтобы помочь предприятиям обслуживать больше моделей искусственного интеллекта с меньшим количеством GPU.
Данное сотрудничество, объявленное 23 июля 2026 года, объединяет решение Tensormesh для кэша KV, управление LMCache, технологию GPU AMD и компонент виртуализации AMD Live Context. Новая архитектура больше не ограничивает активные данные вывода высокоскоростной памятью (HBM), а позволяет кэшу KV переполняться в иерархическую структуру, охватывающую DRAM, SSD и удалённое хранилище.
Объём памяти стал фактическим узким местом для вывода больших языковых моделей. Увеличение количества GPU обеспечивает больше HBM, но также повышает стоимость ускорителей, энергопотребление и требования к инфраструктуре. Создание процессоров с более крупным пулом памяти на аппаратном уровне может решить ту же проблему, но усилит спрос на и без того ограниченные компоненты памяти. Tensormesh и AMD предложили альтернативный подход: что, если предприятия смогут лучше использовать уже имеющуюся память в каждом узле?
Целевым объектом стали данные кэша KV. В процессе вывода трансформерные модели хранят промежуточные данные внимания, чтобы избежать повторного вычисления полного контекста диалога или документа для каждого генерируемого токена. Когда подсказки длинные, уровень параллелизма высок или несколько моделей совместно используют кластер вывода, кэш может стать очень большим. Исследовательская работа vLLM с помощью PagedAttention привлекла внимание отрасли к более эффективному распределению кэша KV, выявив влияние управления памятью на пропускную способность вывода.
LMCache расширяет эту концепцию на несколько уровней памяти. По данным Tensormesh, блоки кэша, выгруженные из HBM для краткосрочной виртуализации, впоследствии могут быть повторно использованы для сопоставления кэша KV с префиксом или без префикса. Перемещение данных в более медленное хранилище увеличивает ёмкость, но ключом к возможному восстановлению производительности в этой архитектуре является избежание повторных вычислений.
Тестирование проводилось на сервере Dell с 8 ускорителями AMD/ATI (MI355) GPU и хранилищем Dell. При работе с набором документов Kimi-K2.6 объёмом 300 ГБ Tensormesh и AMD сообщили о снижении задержки первого токена с 3,4 секунды до менее 0,5 секунды, что представляет собой улучшение почти в 7 раз. Этот результат был достигнут за счёт извлечения кэшированных данных KV из DRAM и NFS, а не повторных вычислений. По мере увеличения рабочей нагрузки пропускная способность вывода оставалась на уровне примерно 48 токенов в секунду; для сравнения, неоптимизированная пропускная способность вывода при той же нагрузке снизилась почти на 40%. Согласно представленным результатам, плотность моделей на том же оборудовании также удвоилась.
Соответствующие результаты были объявлены поставщиками, а не получены в ходе широких независимых тестов. Командам предприятий необходимо воспроизвести результаты, используя свои собственные модели, длину подсказок и профили параллелизма. MLCommons предоставляет контекст необходимости стандартизированных тестов вывода: производительность может значительно варьироваться в зависимости от модели, целевой задержки, конфигурации сервера и подхода к рабочей нагрузке.
Удвоение плотности моделей означает не только размещение большего количества моделей в одной стойке, но и потенциальное влияние на экономику внутренних помощников, систем генерации с расширенным поиском и анализа документов за счёт распределения стоимости ускорителей на большее количество рабочих нагрузок. Это потенциальное преимущество особенно важно для предприятий, работающих с большими коллекциями документов, поскольку повторяющийся контекст создаёт возможности для повторного использования кэша.
Данный метод имеет компромиссы. DRAM медленнее HBM, а SSD и удалённое хранилище вносят дополнительную задержку и риск конкуренции за сеть. Эффективная иерархия зависит от определения того, какие данные кэша должны оставаться рядом с GPU, а какие можно перемещать без ущерба для целей уровня обслуживания; частота попаданий в кэш, пропускная способность хранилища и поведение оркестрации могут быть так же важны, как и номинальная ёмкость.
Более широкое давление вряд ли быстро ослабнет. Стэнфордский институт искусственного интеллекта, ориентированного на человека (Stanford HAI), документирует растущие вычислительные потребности, связанные с передовыми системами ИИ, что дополнительно подтверждает важность повышения эффективности использования наряду с развёртыванием дополнительного оборудования.
До этого сотрудничества AMD Ventures участвовала в раунде финансирования Tensormesh на сумму 20 миллионов долларов США, завершённом в мае 2026 года. Tensormesh и AMD на этой неделе демонстрируют результаты производительности на мероприятии AMD Advancing AI 2026, а открытый исходный код LMCache, как ожидается, будет опубликован через месяц. Эта публикация может расширить область экспериментов с многоуровневым управлением кэшем KV и дать командам инфраструктуры более чёткое представление о том, как этот метод работает за пределами первоначальной тестовой среды Dell.
Связанные продукты

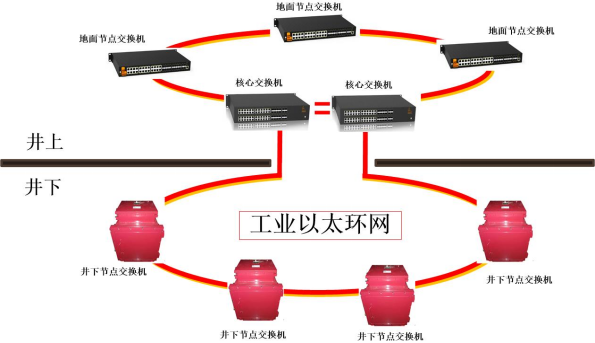
Промышленная кольцевая сеть Ethernet для горнодобывающей промышленности (10 Гбит/с / 1 Гбит/с)
Chongqing Mas Sci&Tech Co., Ltd.
Автоматический патрульный робот/автоматический робот безопасности
FOTUN HONGKONG LIMITED
Интеллектуальный автоматический калибратор давления ConST811A
Beijing ConST Instruments Technology Inc.
Интеллектуальная система мониторинга конвейерных лент
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Антенные системы и сопутствующая электронная продукция
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.
Контроллер системы обнаружения горючих газов 30
Jinan Benan Technology Development Co., Ltd.
Тропосферный ветровой профилемер P-диапазона TWP16
China Huayun Meteorological Technology Group Co., Ltd.