Китайская компания SenseTime открыла исходный код SenseNova-Vision
Репортаж от Wedoany,13 июля китайская компания SenseTime Technology официально выпустила и открыла унифицированную мультимодальную модель понимания и генерации изображений SenseNova-Vision, предоставляющую единые возможности для таких задач, как обнаружение объектов, оптическое распознавание символов, сегментация изображений, прогнозирование глубины, оценка нормалей поверхности, многовидовая геометрия и оценка положения камеры. В отличие от прежних технических подходов, где для каждой задачи компьютерного зрения требовались отдельные модели, головки прогнозирования и декодеры, SenseNova-Vision преобразует множество задач компьютерного зрения в задачи генерации текста, изображений или их комбинации, позволяя визуальному восприятию напрямую интегрироваться в систему ввода-вывода универсальных мультимодальных моделей.
Открытый доступ включает не только веса модели. SenseTime опубликовала модель SenseNova-Vision-7B-MoT, код для вывода, технический отчет и визуальный корпус SenseNova-Vision-Corpus-50M, а также предоставила интерфейсы для однокадрового вывода, интерактивного вывода, веб-демонстрации и бенчмарков. Согласно официальной проектной документации, указанные модель, набор данных, код вывода и технический отчет были последовательно опубликованы 8 июля, а 13 июля была обнародована полная информация о выпуске.
Традиционные системы компьютерного зрения обычно создают независимые технические цепочки для каждой задачи. Обнаружение объектов требует вывода категорий и ограничивающих рамок, сегментация изображений — генерации попиксельных масок, прогнозирование глубины — вычисления пространственного расстояния для каждого пикселя, а трехмерная реконструкция — обработки многовидовых изображений, карт точек и параметров камеры. Ранее для этих задач часто требовались разные структуры моделей, цели обучения, специализированные модули прогнозирования и методы обработки данных. SenseNova-Vision стремится устранить эту фрагментацию моделей между задачами, не добавляя специализированные архитектурные ветви для обнаружения, сегментации, оценки глубины или геометрического прогнозирования, а позволяя одной модели распознавать тип задачи, целевую область, угол обзора и правила вывода на основе инструкций на естественном языке.
После унификации различные визуальные результаты по-прежнему используют формы выражения, подходящие для их собственных характеристик. Структурированная информация, такая как категории объектов, ограничивающие рамки, координаты точек, результаты распознавания текста, ключевые точки человека и параметры камеры, может быть напрямую сгенерирована моделью в виде текстовых записей; попиксельные результаты, такие как маски сегментации, карты глубины, карты нормалей поверхности и многовидовые трехмерные карты точек, генерируются в виде изображений. Для комбинированных задач, требующих как указания категории объекта, так и вывода соответствующей области сегментации, модель может одновременно генерировать текст и изображение, позволяя одному и тому же интерфейсу взаимодействия охватывать структурированное визуальное понимание, плотное геометрическое прогнозирование, сегментацию изображений и многовидовую визуальную геометрию.
Инструкции на естественном языке становятся важным интерфейсом для соединения различных визуальных задач. Разработчики могут с помощью текстовых описаний указать категорию объекта, цвет, область, угол обзора и формат вывода, а также добавить визуальные подсказки для указания объекта обработки, после чего модель генерирует результаты в соответствии с соглашением. Такой подход позволяет визуальным задачам больше не быть полностью ограниченными фиксированными списками категорий и предопределенными форматами оценки. Например, пользователи могут комбинировать категории, цвета и условия локальных областей с помощью языка, формируя более гибкие требования к визуальной обработке, чем традиционные фиксированные задачи.
Для поддержки этого унифицированного подхода к обучению SenseTime создала корпус SenseNova-Vision-Corpus-50M. Этот корпус преобразует визуальные аннотации, ранее распределенные по задачам обнаружения, распознавания текста, локализации ключевых точек, сегментации изображений, оценки глубины и многовидовой геометрии, в унифицированную структуру образцов «визуальный ввод, инструкция на естественном языке, декодируемый ответ», где форма ответа охватывает текст, изображения и их комбинацию. В процессе обучения в основном используется этот визуальный корпус с добавлением вспомогательных мультимодальных данных, чтобы уменьшить потерю способностей к общему пониманию и генерации изображений при усилении визуальных возможностей модели.
Судя по опубликованному диапазону задач, SenseNova-Vision в настоящее время охватывает четыре основные категории визуальных способностей. Структурированное визуальное понимание включает обнаружение объектов, референсную локализацию, распознавание текста, локализацию элементов интерфейса и прогнозирование ключевых точек; плотное геометрическое прогнозирование включает монокулярную оценку глубины и прогнозирование нормалей поверхности; сегментация охватывает общую сегментацию, референсную сегментацию, сегментацию на основе рассуждений, интерактивную сегментацию и сегментацию с семантическим описанием; многовидовая визуальная геометрия включает реконструкцию трехмерных карт точек и оценку положения камеры. Официальные результаты бенчмарков показывают, что одна модель может конкурировать с некоторыми специализированными и универсальными визуальными моделями в различных форматах вывода и визуальных задачах, но производительность в разных задачах не является полностью одинаковой.
После открытия модели разработчики могут запускать предустановленные примеры с помощью официального кода, а также указывать тип задачи, текстовые подсказки и входные изображения для однократного вывода. Официально также предоставляется локальная веб-демонстрация на основе Gradio; для полной демонстрации рекомендуется использовать графический процессор с 80 ГБ видеопамяти; для выполнения всех бенчмарков официально рекомендуется настроить сервер как минимум с 8 графическими процессорами по 80 ГБ. Это указывает на то, что, хотя SenseNova-Vision уже предоставляет полный интерфейс для вывода, для развертывания и оценки всех задач все еще требуются значительные вычислительные ресурсы.
Лицензия на открытый доступ также имеет четкие границы. Веса модели SenseNova-Vision распространяются по лицензии CC BY-NC 4.0, в основном для некоммерческого использования; страница набора данных также имеет ту же лицензию; исходный код в официальном репозитории GitHub должен использоваться отдельно в соответствии с лицензией, указанной в репозитории. Таким образом, «полное открытие исходного кода» в основном означает, что модель, обучающий корпус, код вывода, технический отчет и методы оценки были открыты для исследовательского сообщества, но не означает, что все содержимое может быть неограниченно использовано непосредственно в коммерческих продуктах.
SenseTime также перечислила текущие ограничения в описании модели. Унифицированная модель не означает, что она превосходит специализированные системы в каждой конкретной задаче; некоторые специализированные модели могут сохранять преимущества в определенных бенчмарках; текстовый вывод все еще требует настройки программ-парсеров в зависимости от задачи, а результаты изображений также необходимо декодировать в соответствии с протоколом обучения. Результаты, такие как глубина, нормали поверхности, трехмерные карты точек и положение камеры, перед использованием в робототехнике, автономном вождении, промышленном контроле или других сценариях с высокими требованиями безопасности, должны быть проверены независимыми системами, и результаты, сгенерированные моделью, не могут быть напрямую использованы в качестве основы для окончательного управления.
Основное техническое изменение, реализованное SenseNova-Vision, заключается в реорганизации ранее разрозненных классических задач компьютерного зрения в задачи генерации, которые может обрабатывать универсальная мультимодальная модель. Обнаружение, сегментация, прогнозирование глубины и трехмерная геометрия больше не соответствуют отдельным изолированным системам, а совместно используют пространство инструкций на естественном языке, визуального ввода и генерации текста и изображений, предоставляя новый путь для дальнейшей интеграции визуального восприятия, понимания языка, генерации изображений и пространственных рассуждений в одну базовую модель.
Связанные продукты

Система управления жизненным циклом оборудования
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.
九天航驭—智能管服平台"JiuTian" OneSky Pilot-Intelligent Management And Service Platform
China Times Prospect Science & Technology Co., Ltd.
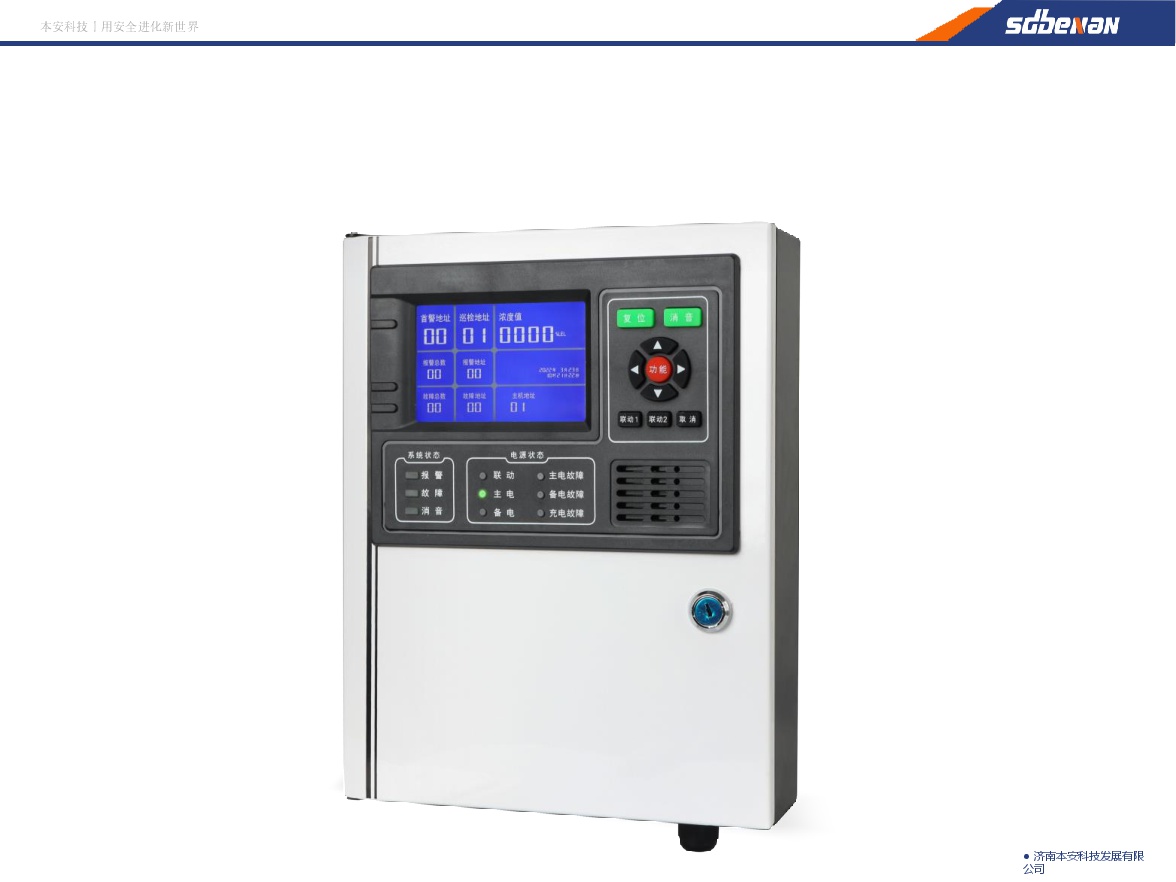
Контроллер системы обнаружения горючих газов 30
Jinan Benan Technology Development Co., Ltd.
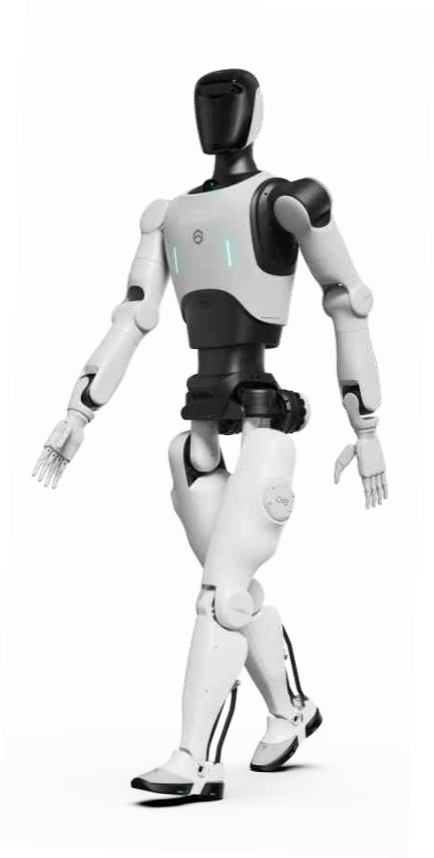
D12 гуманоидный робот
Automation Research Institute Co., Ltd. of China South Industries Group Corporation
Тропосферный ветровой профилемер P-диапазона TWP16
China Huayun Meteorological Technology Group Co., Ltd.
QPS-20A Резервированный переключатель питания
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.