Microsoft Research представила Memora: снижение расхода токенов на 98%
Репортаж от Wedoany,Исследовательское подразделение Microsoft разработало долговременную систему памяти Memora, предназначенную для обеспечения ИИ-агентов более масштабируемой и надёжной памятью за счёт разделения содержимого памяти и способов её извлечения.
Поскольку ИИ-агентам необходимо сохранять контекстную память в течение недель или месяцев, а не обрабатывать только отдельные сеансы, традиционные методы работы с памятью приводят к фрагментации информации и замедлению поиска. Microsoft Research заявляет, что Memora, разделяя содержимое памяти и способы её извлечения, позволяет сократить использование контекстных токенов до 98%, сохраняя или превосходя точность полного контекста.
В настоящее время долгосрочное развёртывание ИИ сталкивается с узким местом в системах памяти. Современные большие языковые модели каждый сеанс начинают с нуля, длинные диалоги требуют многократного чтения всей истории, новая информация хранится в виде исходного текста или сводок, а ключевые детали могут быть утеряны.
Существующие решения имеют свои ограничения. Система Mem0 извлекает атомарные факты из диалогов, метод генерации с дополнением поиска (RAG) индексирует текстовые фрагменты, а графовые системы памяти (например, Zep, GraphRAG) строят структуры на основе связей между сущностями. Однако эти методы впадают в две крайности: системы с фрагментацией содержимого (например, RAG, Mem0) сохраняют детали, но теряют связность повествования; системы с крупнозернистой абстракцией сжимают опыт, но теряют ограничения и числовые детали; графовые системы требуют строгой онтологии, а поиск зависит от самого содержимого.
Архитектура Memora решает эти проблемы за счёт разделения хранимого содержимого и способов его извлечения. Каждая запись памяти состоит из двух частей: основная абстракция представлена фразой из 6–8 слов, отражающей базовое содержание памяти; значение памяти содержит само богатое содержимое. Новая информация по той же теме объединяется с существующими записями памяти, избегая фрагментации. Кроме того, система вводит якоря-подсказки — короткие, контекстно-зависимые метки, извлекаемые из каждого значения памяти, обеспечивающие альтернативные пути доступа к одной и той же памяти.
Memora также включает стратегически управляемый поисковик, который не возвращает сразу k наиболее похожих элементов, а итеративно уточняет запрос через якоря-подсказки, представляя релевантные, но непохожие воспоминания, и решает, когда остановиться. Главный аналитик Greyhound Research Санчит Вир Гогия (Sanchit Vir Gogia) отметил, что Memora отвергает упрощение, приравнивающее поиск к памяти, отделяя богатые детали памяти от дескрипторов поиска, превращая поиск в навигационное действие.
Microsoft оценила Memora на двух эталонных тестах: LoCoMo (в среднем 600 раундов диалога) и LongMemEval (контекст из 115 000 токенов). Результаты показали, что Memora достигла точности оценки LLM 86,3% на LoCoMo и 87,4% на LongMemEval, превзойдя RAG, Mem0, Nemori, Zep, LangMem и полноконтекстное рассуждение. Количество записей памяти, хранимых Memora на один диалог (344), примерно вдвое меньше, чем у Mem0 (651), при этом расход токенов сокращается до 98% по сравнению с полноконтекстным рассуждением.
Гогия указал, что снижение расхода токенов не эквивалентно снижению затрат на инфраструктуру. Сокращение контекста в эталонных тестах не означает, что счета предприятий снизятся на 98%; фактические затраты также включают построение памяти, индексацию, хранение и журналы аудита. Самый мощный стратегический режим поиска Memora занимает около пяти-шести секунд на запрос, тогда как более простой семантический режим — менее секунды; экономия токенов подсказок частично нивелируется задержкой поиска и дополнительными рассуждениями.
В настоящее время Memora является активным проектом Microsoft Research, а соответствующий исследовательский код опубликован на GitHub. Гогия рекомендовал ИТ-руководителям рассматривать Memora как архитектурное исследование, а не как готовое к производству программное обеспечение, и проявлять осторожность до тех пор, пока её код не станет полностью проверяемым, поддерживаемым и сопровождаемым. Кроме того, предприятиям необходимо разработать политики управления и соответствия, обеспечивающие безопасное управление и аудит памяти ИИ, включая чёткое определение того, кто может записывать или читать память, как долго она хранится и как аудиторы могут её реконструировать, чтобы соответствовать требованиям таких нормативных актов, как Закон ЕС об искусственном интеллекте и индийский Закон о защите цифровых персональных данных.
Связанные продукты

Антенные системы и сопутствующая электронная продукция
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.
Тропосферный ветровой профилемер P-диапазона TWP16
China Huayun Meteorological Technology Group Co., Ltd.
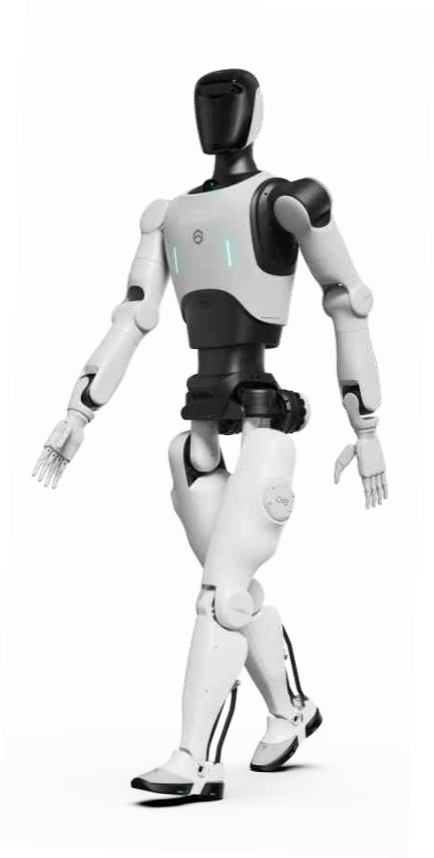
D12 гуманоидный робот
Automation Research Institute Co., Ltd. of China South Industries Group Corporation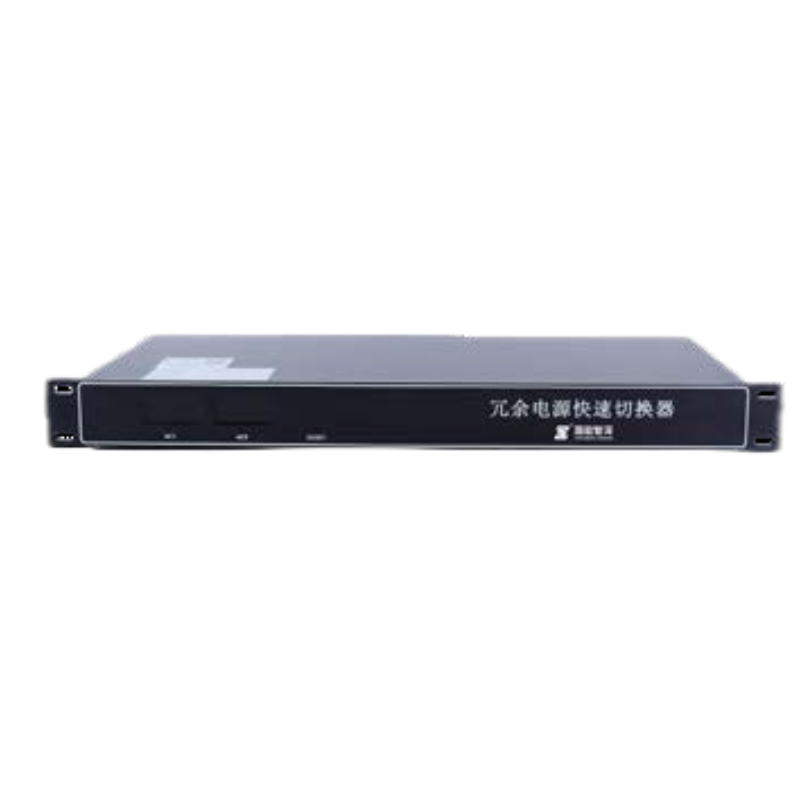
QPS-20A Резервированный переключатель питания
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.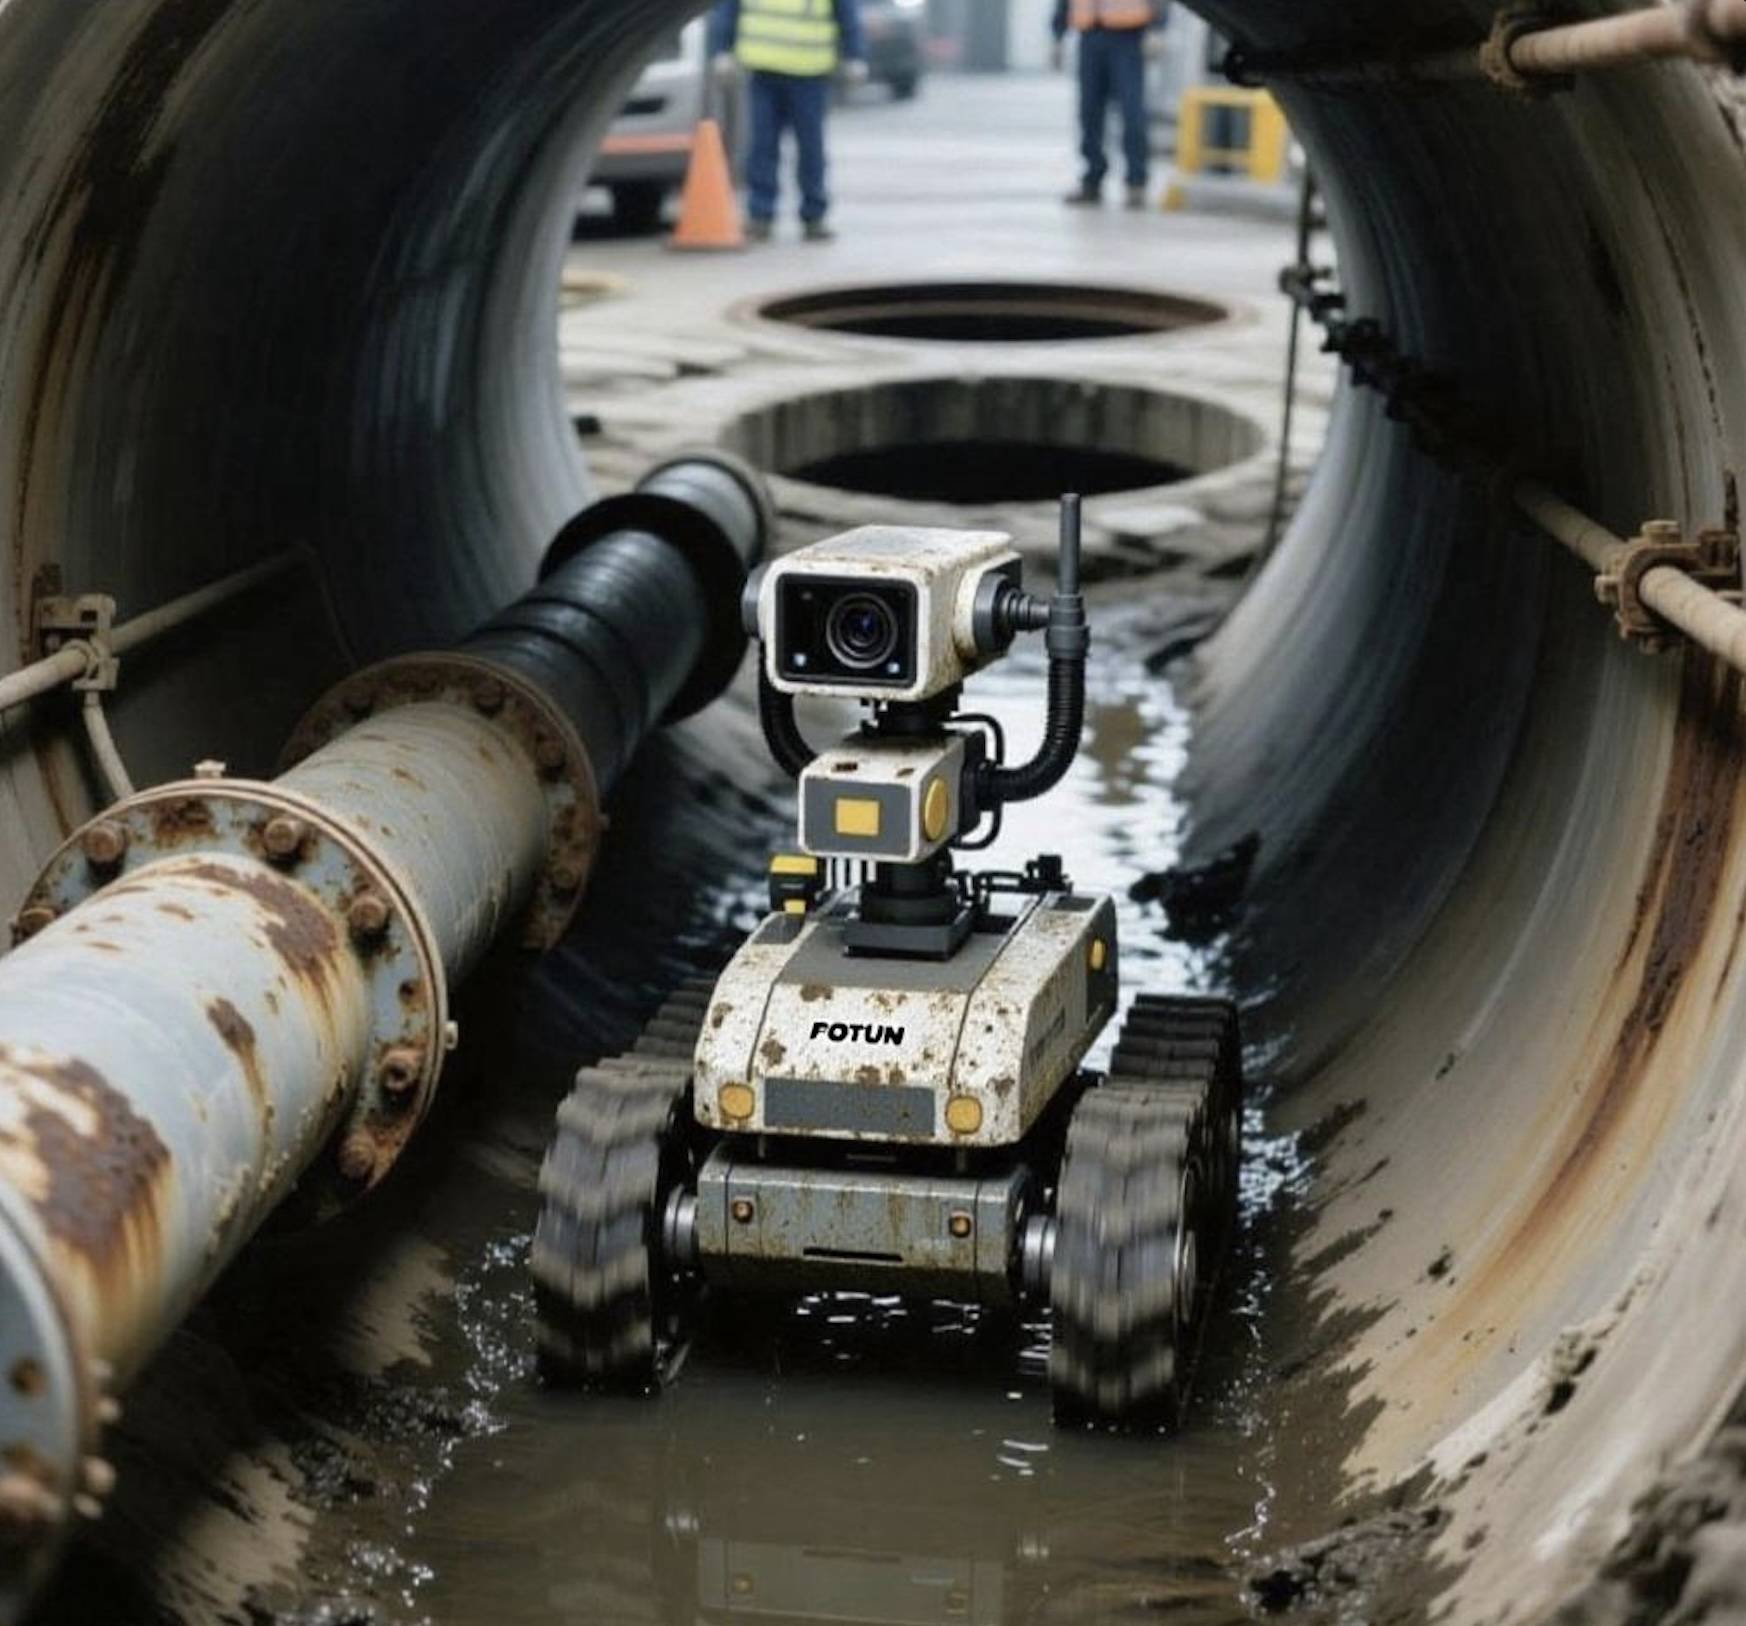
Автоматический патрульный робот/автоматический робот безопасности
FOTUN HONGKONG LIMITED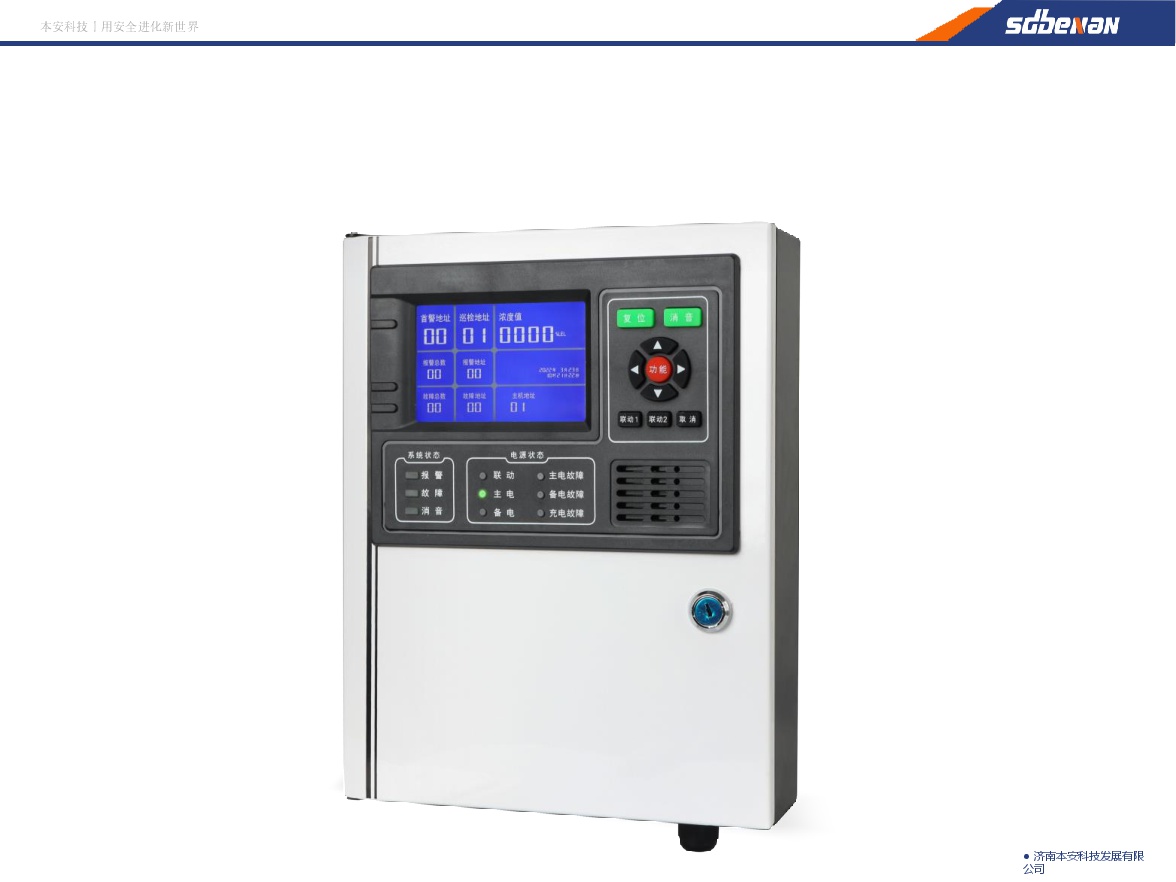
Контроллер системы обнаружения горючих газов 30
Jinan Benan Technology Development Co., Ltd.
Интеллектуальный автоматический калибратор давления ConST811A
Beijing ConST Instruments Technology Inc.
Система управления жизненным циклом оборудования
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.