Компания Qualcomm (США) представила ускоритель AI250 на базе HBC на Дне инвестора 2026 года
Репортаж от Wedoany,Qualcomm объявила о выходе на рынок ИИ-инфраструктуры для центров обработки данных. На прошлой неделе (в ходе Дня инвестора 2026 года) компания представила серию ускорителей AI250, основанных на архитектуре near-memory computing. Эта технология использует стековую DRAM для формирования единого вычислительного и запоминающего модуля, обеспечивая более высокую эффективность вывода по сравнению с текущими GPU.
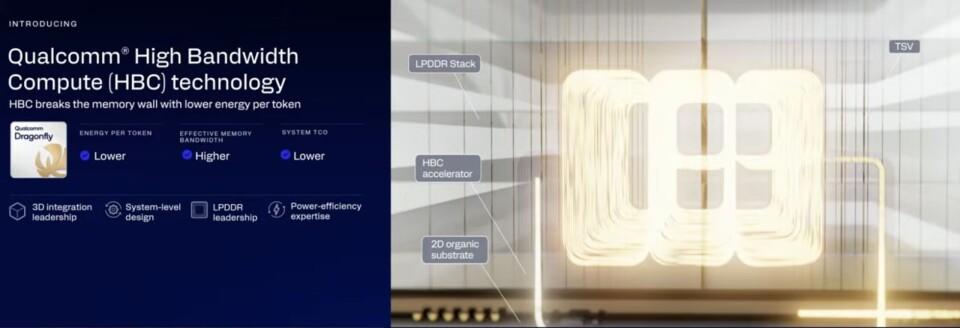
Qualcomm назвала эту технологию High Bandwidth Computing (HBC). Исполнительный вице-президент по ЦОД Тони Пиалис (Tony Pialis) заявил в ходе презентации для инвесторов, что HBC сочетает в себе преимущества производительности SRAM с плотностью и емкостью памяти стеков HBM. Серия AI250 планируется к выпуску в следующем году в составе стоечной системы Dragonfly, что знаменует собой явный сдвиг в стратегии Qualcomm в области ИИ-инфраструктуры. Несмотря на то, что процессоры Snapdragon уже имеют встроенные NPU, в сегменте ЦОД Qualcomm ранее с трудом добивалась такого же внимания рынка, как Nvidia, AMD или даже такие стартапы, как Cerebras.
По сравнению с GPU двух гигантов, серия ускорителей ИИ от Qualcomm пока не имеет преимуществ, однако компания стремится оставить свой след в сфере ЦОД. Одна карта AI250 заявляет о 768 ГБ емкости памяти и эффективной пропускной способности памяти до 133 ТБ/с. Для справки: Nvidia Groq 3 LPU предлагает лишь 500 МБ SRAM и пропускную способность 150 ТБ/с. Qualcomm признает, что эти цифры зависят от слова «эффективный», поскольку система Dragonfly на базе AI200, утверждающая общую «эффективную» пропускную способность памяти всех 56 чипов в 414 ТБ/с, для достижения этого значения с использованием лишь LPDDR5x на 8800 МТ/с потребовала бы шину шириной 6720 бит, которой у компании почти наверняка нет. Qualcomm настаивает, что это «чистая физическая пропускная способность интерфейса LPDDR», но отказывается объяснять, как она достигает эффекта, для которого Nvidia требуется восемь стеков HBM3e.
Маркетинговые материалы Qualcomm показывают, что с переходом на HBC AI250 обеспечит в 18 раз большую эффективную пропускную способность, чем AI200, а будущий AI300 — в 54 раза. Эти «эффективные» множители на самом деле являются особенностью архитектуры HBC. Размещая часть вычислительных блоков XPU под DRAM, можно значительно снизить энергопотребление чипа. Традиционные GPU для ЦОД полагаются на обмен данными между HBM и вычислительным кристаллом, и даже при использовании передовых методов упаковки, таких как TSMC CoWoS, энергопотребление остается значительным. HBC же, размещая DRAM непосредственно поверх части логики и используя соединения через кремниевые переходные отверстия (TSV), значительно сокращает путь от вычислений к памяти. Пиалис сравнил это с работой в здании, где вы живете: нужно лишь перемещаться вверх и вниз, без необходимости использовать автомагистрали и дорогие кремниевые интерпозеры.
Преимущество выполнения операций, ограниченных пропускной способностью, на базовом кристалле заключается в уменьшении объема данных, передаваемых между HBC и SoC, что, в свою очередь, усиливает пропускную способность памяти. Qualcomm, вероятно, не будет запускать весь стек ИИ-программного обеспечения на HBC, поскольку более высокая пропускная способность памяти в первую очередь выгодна на этапе декодирования, когда все активные веса модели в авторегрессивном режиме последовательно поступают из памяти. Декодирование не является вычислительно интенсивным, поэтому частичное или полное выполнение декодирования в HBC позволяет избежать тепловых ограничений, связанных с размещением вычислительных блоков под несколькими слоями DRAM. Qualcomm заявляет, что AI250 может использоваться как автономный ИИ-ускоритель, так и в архитектуре раздельного вывода, где GPU или другие компоненты Qualcomm выполняют обработку промптов, а AI250 ускоряет операции декодирования, интенсивно использующие память. Qualcomm не предоставила данных о пиковой производительности в FLOPS при анонсе AI250 и по запросу отказалась раскрывать детали.
Хотя Qualcomm была одной из первых компаний-разработчиков чипов, продвигающих near-memory computing или HBC, эта технология не является недосягаемой для Nvidia или AMD. По слухам, и Nvidia, и AMD сотрудничают с поставщиками HBM и TSMC для разработки пользовательских базовых кристаллов с целью повышения производительности своих чипов следующего поколения. Qualcomm заявляет, что ее HBC «использует память LPDDR в специально созданной архитектуре near-memory computing, которая объединяет вычисления и высокоускоренную пропускную способность памяти в 3D-стекированной кремниевой конструкции. HBC — это уникальная архитектура, предназначенная для решения проблемы узкого места перемещения данных в ИИ за счет приближения вычислений к памяти, повышения эффективности пропускной способности памяти и энергоэффективности рабочих нагрузок ИИ-вывода. HBM имеет больше стеков DRAM, использует 2.5D-интерпозеры для прокладки большего количества линий и не выполняет вычисления на базовом логическом кристалле.» Стартап по производству ИИ-чипов d-Matrix также разрабатывает ускорители, использующие 3D-стековую DRAM для расширения возможностей вычислений в памяти.
В ходе Дня инвестора Qualcomm также объявила о приобретении стартапа Modular, занимающегося разработкой ИИ-программного обеспечения. Modular был основан Тимом Дэвисом (Tim Davis) и Крисом Латтнером (Chris Lattner), создателем LLVM, Clang, языка программирования Swift и инфраструктуры компилятора MLIR (многоуровневое промежуточное представление). В Modular Латтнер вместе с командой разработал Mojo — низкоуровневый программный интерфейс для GPU, предлагающий высокопроизводительную альтернативу стекам Nvidia CUDA или AMD HIP и ROCm. Основная идея заключается в том, что пользователи должны иметь возможность писать высокопроизводительные ИИ-приложения, не заботясь о базовом оборудовании. Для Qualcomm Mojo предоставляет возможность обойти «ров» CUDA: клиентам не нужно выбирать одну платформу, они могут разрабатывать приложения и запускать их на любых доступных вычислительных ресурсах. Modular также разработала сервисную платформу под названием Max, аналогичную SGLang или vLLM, которая может взаимозаменяемо работать на оборудовании AMD или Nvidia. Поскольку она построена на Mojo, теоретически она требует минимальной ручной настройки.
Если приобретение удастся завершить в этом году без вмешательства регулирующих органов, этот продукт должен помочь Qualcomm конкурировать в среде, где программное обеспечение становится важнее аппаратного. Qualcomm планирует выпустить стоечную систему серии AI200 позднее в этом году, первый HBC-ускоритель AI250 — начиная с 2027 года, а второе поколение платформы HBC запланировано на 2028 год. Ранее компания также раскрыла информацию о своем новом процессоре для ЦОД.
Связанные продукты

KJD127(A) шахтный взрывозащищённый и искробезопасный компьютер
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.
QPS-20A Резервированный переключатель питания
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.
Интеллектуальный автоматический калибратор давления ConST811A
Beijing ConST Instruments Technology Inc.
Интеллектуальное производство, проектирование PCB
GCI Science & Technology (Zhuhai) Co., Ltd.
Планшетный портативный спутниковый терминал Ручной портативный терминал с антенной диаметром 0,35 м
China Starwin Science & Technology co., Ltd.
Интеллектуальная система мониторинга конвейерных лент
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.

Автоматический патрульный робот/автоматический робот безопасности
FOTUN HONGKONG LIMITED
Промышленная кольцевая сеть Ethernet для горнодобывающей промышленности (10 Гбит/с / 1 Гбит/с)
Chongqing Mas Sci&Tech Co., Ltd.