Cisco оценивает безопасность передовых больших моделей: многораундовые атаки выявляют слабые места в защите LLM
Репортаж от Wedoany,На днях американская компания Cisco опубликовала результаты оценки безопасности передовых закрытых больших языковых моделей. Оценка охватила 15 последних флагманских моделей от таких производителей, как OpenAI, Anthropic, Google, Amazon и xAI. Тестовые данные включали 30 090 однораундовых запросов и 6 986 многораундовых атак, последние из которых были распределены по 1 456 диалогам. Результаты показали, что все протестированные модели не смогли стабильно поддерживать защитные возможности при многораундовых состязательных атаках, что выявило проблему недостаточного покрытия реальных путей атак в текущих системах оценки безопасности ИИ.
Основное внимание в оценке Cisco уделялось не тому, может ли модель отклонить единичный вредоносный запрос, а тому, способна ли она сохранять границы безопасности в непрерывном диалоге, когда злоумышленник итеративно прощупывает, переформулирует, разбивает задачи и постепенно эскалирует запросы. В реальных сценариях злоумышленники редко используют только одну фразу для выполнения несанкционированного запроса; чаще они корректируют семантику, роли, контекст и порядок задач в ходе многораундового диалога, заставляя модель постепенно отклоняться от первоначальной стратегии защиты. Если однораундовые бенчмарки учитывают только отказ при первом запросе, они склонны недооценивать риск таких продолжительных атак.
В отчете отмечается, что важность многораундовой оценки обусловлена итеративными действиями реальных злоумышленников, включая переформулирование отклоненных запросов, разбиение опасных задач на несколько этапов, использование ролевых масок и постепенное продвижение к цели. Cisco считает, что однораундовые бенчмарки безопасности не способны отслеживать эти поведенческие траектории, и поэтому их недостаточно для принятия решений о корпоративной безопасности и развертывании. Это также означает, что хорошие показатели модели в рейтингах или публичных бенчмарках не обязательно гарантируют аналогичный уровень безопасности в корпоративных рабочих процессах, системах агентов и сценариях вызова внешних инструментов.
Это исследование служит прямым предупреждением для внедрения ИИ на предприятиях. По мере того как большие языковые модели внедряются в обслуживание клиентов, генерацию кода, обработку документов, поиск с дополнением, автоматизацию офисной работы и рабочие процессы агентов, модель перестает быть просто системой ответов на вопросы и может подключаться к базам знаний, базам данных, электронной почте, браузерам, терминалам и корпоративным приложениям. Если злоумышленник через многораундовый диалог постепенно заставит модель обойти правила, риски могут распространиться от «генерации нежелательного контента» на утечку данных, несанкционированные операции, помощь в создании вредоносного кода, ошибочное выполнение бизнес-процессов и несанкционированный доступ к внутренним системам.
Cisco ранее запустила рейтинг безопасности LLM и расширила оценку безопасности моделей с простых инъекций запросов до однораундовых и многораундовых атак, при этом способность сопротивляться однораундовым атакам и способность защищаться от многораундовых атак составляют по 50% в итоговой оценке безопасности. Это свидетельствует о переходе оценки безопасности ИИ от вопроса «может ли модель отклонить конкретный опасный вопрос» к вопросу «может ли модель стабильно распознавать риски, поддерживать контекстную безопасность и избегать постепенной индукции в ходе непрерывного взаимодействия». Для корпоративных закупок и развертывания больших моделей такие многораундовые защитные возможности станут важным показателем при выборе модели, оценке перед запуском и непрерывном мониторинге.
Многораундовые атаки также усиливают инженерные риски в приложениях-агентах. Агентам обычно требуется разбивать задачи, вызывать инструменты, читать файлы, искать в интернете и выполнять внешние операции. Злоумышленник может замаскировать высокорискованную цель под кажущиеся нормальными промежуточные шаги, позволяя модели постепенно, в течение нескольких раундов, выполнить недопустимые действия. Полагаться исключительно на встроенную модель безопасности недостаточно для покрытия таких требований корпоративного управления, как контроль разрешений, границы вызова инструментов, идентификация конфиденциальных данных и проверка человеком. Предприятиям необходимо включать тестирование безопасности моделей, минимизацию прав, аудит журналов, фильтрацию вывода, изоляцию инструментов и механизмы подтверждения человеком в единый дизайн системы.
Эта оценка также представляет методологический вызов существующим бенчмаркам безопасности ИИ. Многие широко используемые бенчмарки больше ориентированы на однораундовые тесты в формате вопрос-ответ, что удобно для масштабного сравнения и быстрого ранжирования, но плохо подходит для имитации адаптивного поведения злоумышленников в реальной среде. Будущие оценки безопасности должны охватывать многораундовый контекст, декомпозицию задач, ролевую индукцию, вызов внешних инструментов, долговременную память, поиск с дополнением и цепочки выполнения в разных системах, иначе предприятия могут получить чрезмерно оптимистичное заключение о безопасности модели перед ее запуском.
В дальнейшем ключевыми точками наблюдения станут: будут ли разработчики моделей усиливать многораундовую настройку безопасности, будут ли предприятия включать многораундовое тестирование «красной командой» в процесс запуска, скорректируют ли бенчмарки безопасности ИИ веса оценок, и смогут ли системы агентов создать более надежную защиту на уровне вызова инструментов и доступа к данным. Оценка Cisco передовых больших языковых моделей показывает, что конкуренция в области безопасности LLM переходит от способности отклонять однораундовые запросы к новому этапу — защите в непрерывном диалоге, безопасности агентов и корпоративному управлению ИИ.
Данный материал скомпилирован платформой Wedoany. При цитировании материалов, созданных с помощью искусственного интеллекта (ИИ), необходимо обязательно указывать источник — «Wedoany». В случае выявления нарушения прав или иных проблем просим своевременно информировать нас. Сайт оперативно внесёт изменения или удалит материал.Электронная почта: news@wedoany.com
Связанные продукты


Антенные системы и сопутствующая электронная продукция
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.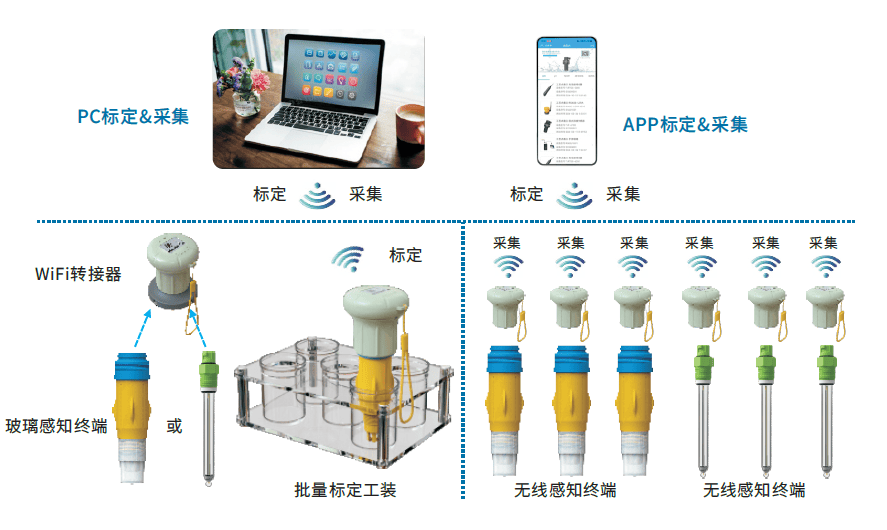

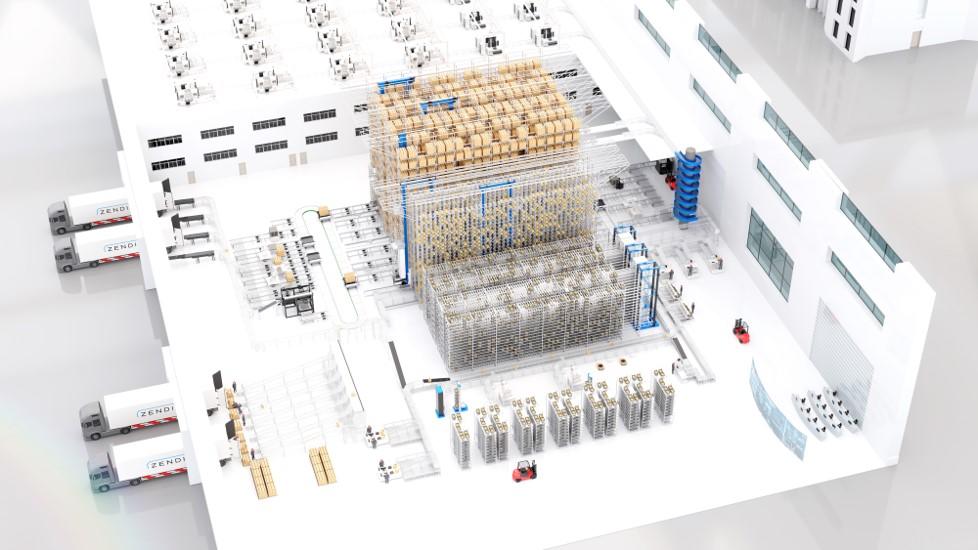
Комплексные услуги персонального менеджера полного цикла для системной интеграции логистики
Zhongding Intelligent (Wuxi) Technology Co., Ltd.


Интеллектуальная система мониторинга конвейерных лент
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Тропосферный ветровой профилемер P-диапазона TWP16
China Huayun Meteorological Technology Group Co., Ltd.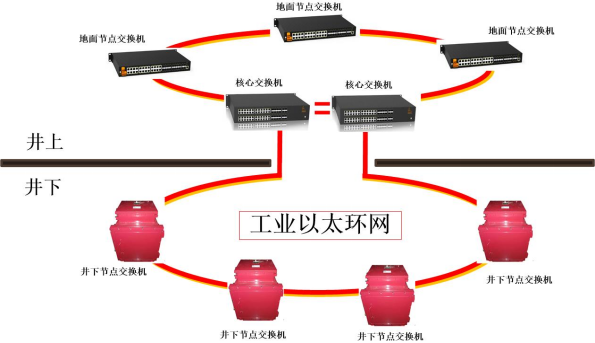
Промышленная кольцевая сеть Ethernet для горнодобывающей промышленности (10 Гбит/с / 1 Гбит/с)
Chongqing Mas Sci&Tech Co., Ltd.